
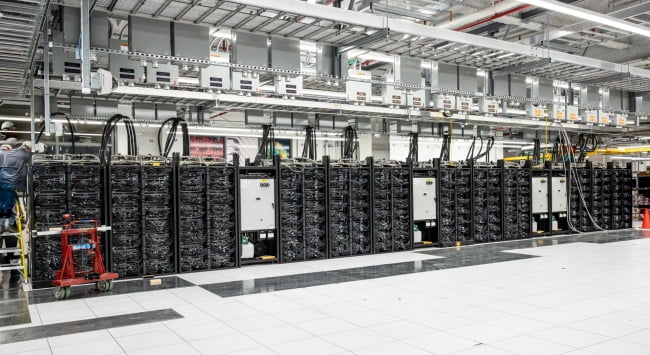
Инженеры AMD опубликовали очередную серию патчей для ядра Linux — на этот раз для когерентного отображения памяти устройств. Работа связана с подготовкой к суперкомпьютеру Frontier, но код может использоваться и в других системах, а также представляет интерес для других производителей оборудования.
Разберём, что такое когерентная память, зачем она нужна и как это отражается на обычных Linux-системах.
Проблема: CPU и GPU видят память по-разному
В классической системе процессор и видеокарта имеют раздельную память. Чтобы GPU обработал данные, их нужно скопировать в видеопамять, а результат — обратно. Копирование стоит времени и энергии.
Если память общая и когерентная, оба устройства видят одни и те же данные без явных копий. Это упрощает программирование и ускоряет задачи, где CPU и GPU работают вместе.
# посмотреть топологию NUMA и устройства
numactl --hardware
lscpu | grep -i numa
# проверить GPU и драйвер
lspci -nnk | grep -A3 -iE "vga|3d|display"
Типы памяти устройств в ядре
В подсистеме HMM (Heterogeneous Memory Management) различают несколько типов памяти устройств. MEMORY_DEVICE_GENERIC описывает память, которую можно отобразить в таблицы страниц процессора. MEMORY_DEVICE_PRIVATE — память, недоступную CPU напрямую, для миграции страниц.
Новый тип MEMORY_DEVICE_COHERENT описывает память устройства, которая может быть отображена в таблицы страниц CPU, как generic, и при этом обладает свойствами private. Проще говоря, CPU может обращаться к ней напрямую, но когерентность и миграция требуют поддержки со стороны драйвера.
# посмотреть, какие типы памяти поддерживает ядро
grep -E "CONFIG_HMM|CONFIG_DEVICE_PRIVATE|CONFIG_ZONE_DEVICE" /boot/config-$(uname -r)
# проверить наличие устройств в /sys
ls /sys/class/mem 2>/dev/null | head
Зачем это Frontier
Frontier — экзафлопсный суперкомпьютер на базе AMD EPYC и ускорителей Instinct. В таких системах узким местом становится не только вычисление, но и передача данных между CPU и GPU. Когерентная память позволяет сократить копирование и упростить модели программирования.
AMD публиковала патчи постепенно: обработка памяти, специальные регионы, взаимодействие между процессорами и графическими ускорителями. Новая серия — ещё один шаг к полноценной поддержке.
# на системах с AMD GPU проверить драйвер и версию прошивки
dmesg | grep -iE "amdgpu|kfd" | head -30
cat /sys/class/drm/card0/device/uevent 2>/dev/null | head
# проверить поддержку ROCm
rocminfo 2>/dev/null | head -30
Что это значит для программиста
Когерентная память полезна для задач, где данные активно переиспользуются: обучение моделей, физическое моделирование, обработка изображений. Если CPU и GPU могут работать с одной областью памяти, код становится проще, а задержки — ниже.
Но «когерентная» не означает «бесплатная». Согласование кэшей, барьеры и синхронизация всё равно нужны. Программисту приходится думать о том, кто и когда обращается к данным.
# пример проверки поддержки unified memory в CUDA (для NVIDIA)
nvidia-smi --query-gpu=name,memory.total --format=csv
# для AMD ROCm посмотреть документацию по HIP
hipcc --version 2>/dev/null
Для обычных приложений ничего не меняется: они не используют эти механизмы напрямую. Влияние почувствуют разработчики HPC-кода и драйверов.
Почему патчи идут в основное ядро
Поддержка экзотического оборудования в ядре полезна не только одному вендору. Общие интерфейсы позволяют другим производителям реализовать свои драйверы без дублирования кода. Это снижает фрагментацию и упрощает поддержку дистрибутивов.
AMD традиционно публикует патчи открыто и работает с сообществом. Не все серии принимаются сразу: часть уходит на доработку после ревью.
# посмотреть, какие параметры HMM доступны
ls /sys/kernel/mm/ 2>/dev/null | grep -i hmm
# проверить журнал ядра на сообщения о device memory
journalctl -k -b | grep -iE "hmm|device memory|coherent" | head -20
Ограничения и риски
- Поддержка зависит от оборудования и прошивки.
- Когерентность может снижать производительность при неудачном доступе.
- Драйверы должны корректно обрабатывать миграцию страниц.
- Ошибки в таких механизмах приводят к повреждению данных.
- Код молодой: нужны тесты на реальных нагрузках.
Для серверов это означает осторожное внедрение: сначала пилот, потом продакшн. Не стоит включать экспериментальные функции на системе с важными данными без резервной копии.
# перед экспериментами сохранить состояние
uname -r > ~/kernel-before.txt
lspci -nnk > ~/lspci-before.txt
dmesg > ~/dmesg-before.txt
Как это связано с HMM и GPUs
HMM позволяет процессору обращаться к памяти, которая физически находится на устройстве. Это нужно для вычислений на GPU без явного копирования. Механизм сложен: нужно отслеживать страницы, обрабатывать ошибки доступа и мигрировать данные.
MEMORY_DEVICE_COHERENT дополняет картину: память принадлежит устройству, но CPU может её отобразить. Это особенно полезно для ускорителей с большой памятью, где копирование всего массива данных неэффективно.
# посмотреть, как ядро описывает память
cat /proc/iomem | head -30
# проверить NUMA-узлы и память
numactl --hardware | head -30
Практический вывод для администратора
Если вы обслуживаете HPC-кластер, следите за версией ядра и драйверов. Новые функции появляются в основной ветке раньше, чем в стабильных дистрибутивах. Для Frontier-подобных систем важна согласованность версий: ядро, прошивка, ROCm и библиотеки.
Для домашней лаборатории тема пока неактуальна: потребительские GPU работают по другим моделям. Но понимание направления помогает при выборе оборудования и чтении документации.
# зафиксировать версии компонентов на узле
uname -r
cat /etc/os-release | head -3
rocminfo 2>/dev/null | grep -E "Name|Version" | head
dmesg | grep -i amdgpu | head -5
И не забывайте про охлаждение и питание: когерентная память не отменяет физику. Плотные вычисления требуют отвода тепла и стабильного электричества.
Итог
AMD опубликовала патчи MEMORY_DEVICE_COHERENT для ядра Linux — тип памяти устройства, который можно отобразить в таблицы страниц CPU. Работа связана с суперкомпьютером Frontier, но имеет общий смысл: упростить обмен данными между CPU и ускорителями. Для обычных пользователей изменений нет, для HPC-инженеров это шаг к более эффективным моделям памяти. Следите за версиями ядра и драйверов, тестируйте на пилоте и не включайте экспериментальные режимы на продакшне без резервных копий.